I) 엔터티(Entity)
1. 엔터티의 개념
-> 개체. 의미 있는 하나의 정보 단위
-> 인스턴스: 엔터티 내에 있는 하나의 행. 최소 하나 이상의 속성을 보유
2. 엔터티의 특징
-> 업무에서 필요로 하는 정보
-> 식별 가능 여부
- 식별자에 의해 한 개씩만 존재하는지 검증
-> 인스턴스의 집합
- 엔터티는 두 개 이상의 인스턴스로 구성
- 인스턴스가 한 개 밖에 없는 엔터티는 집합이 아니므로 엔터티가 아님
-> 업무 프로세스에 의해 활용되어야 함
-> 속성을 포함해야 함
- 주식별자만 존재하고 일반 속성은 전혀 없는 경우 엔터티가 아님
- 엔터티는 엔터티를 설명할 수 있는 속성이 존재해야 의미를 갖음
-> 관계의 존재
- 관계가 설정되지 않은 엔터티는 부적절한 엔터티가 도출되었거나, 다른 엔터티와의 직접적인 연결 관계를 찾지 못한 경우
3. 엔터티의 분류
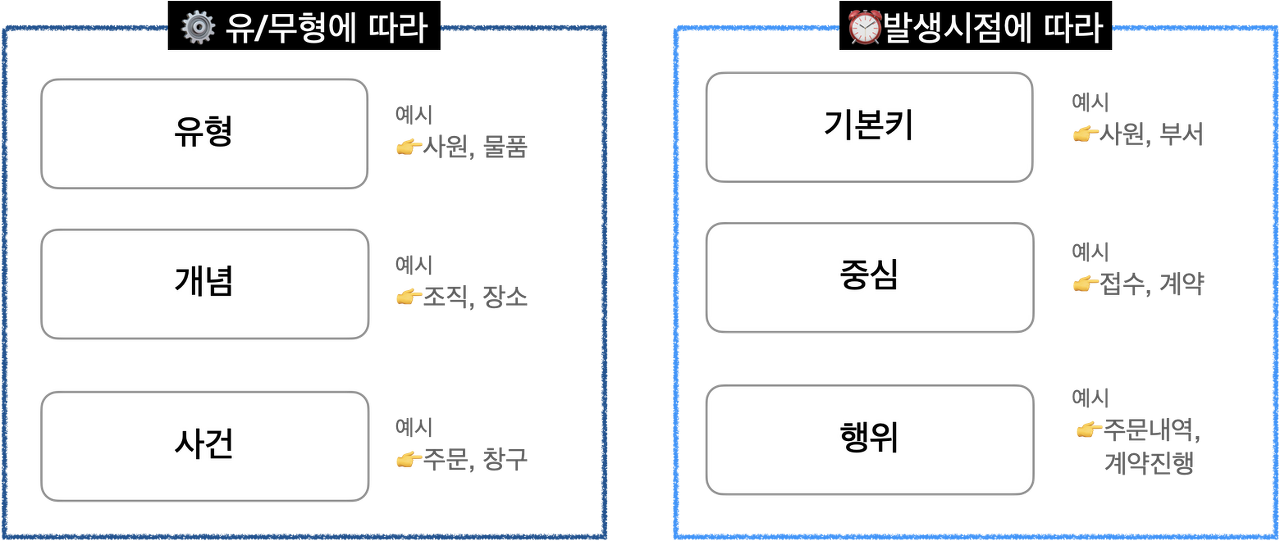
-> 유/무형에 따른 분류
- 유형 엔터티 -> 물리적인 형태가 존재. 안정적이고 지속적 ex) 상품, 강사
- 개념 엔터티 -> 관리해야 할 개념적인 정보로 구분 ex) 학과, 코스닥 종목
- 사건 엔터티 -> 특정한 이벤트에 종속. 각종 통계에 이용 ex) 이벤트 응모, 주문
-> 발생 시점에 따른 분류
- 기본/키 엔터티 -> 독립적인 생성이 가능. 부모 엔터티. 고유한 주식별자 보유 ex) 고객, 상품
- 중심 엔터티 -> 업무에서 중심적인 역할. 다른 엔터티와의 관계를 통해 많은 행위 엔터티를 생성 ex) 주문, 취소
- 행위 엔터티 -> 두 개 이상의 부모 엔터티로부터 발생 ex) 주문 내역, 취소 내역
4. 엔터티의 이름짓기 방식
- 업무에서 사용하는 용어 사용
- 축약어 사용 지양
- 단수 명사 사용 및 띄어쓰기 금지
- 모든 엔터티에 유일한 이름을 부여(중복X)
- 엔터티 생성 의미대로 이름을 부여
II) 속성(Attribute)
1. 속성의 개념
-> 인스턴스가 가진 어떠한 성질
-> 더 이상 분리되지 않는 최소의 데이터 단위
-> 엔터티, 인스턴스, 속성, 속성값의 관계
- 한 개의 엔터티는 두 개 이상의 인스턴스의 집합
- 한 개의 엔터티는 두 개 이상의 속성으로 구성
- 한 개의 속성은 한 개의 속성값을 보유
2. 속성의 특징 및 분류
-> 속성의 특징
- 업무에서 필요로 하는 것
- 더 이상 분리되지 않고 그 자체로 독립성을 유지 -> 가장 작은 단위
- 엔터티를 설명하고 인스턴스의 구성요소
- 정규화 이론에 기반을 두고 주식별자에 함수적 종속성을 가짐
- 하나의 속성은 단 한 개의 값만 보유 -> 하나의 속성에 여러 개의 값이 있으면 별도의 엔터티로 분류하여 관리
-> 속성의 특징에 따른 분류
- 기본 속성 -> 업무로부터 추출된 모든 속성
- 설계 속성 -> 데이터 모델링, 업무의 규칙화 등을 위해 새로 만들거나 변형하여 정의하는 속성
- 파생 속성 -> 다른 속성에 영향을 받아 발생하는 속성. 보통 계산된 형태의 값. 적게 정의하는 것이 이득
-> 엔터티 구성 방식에 따른 분류
- PK(Primary Key) 속성 -> 엔터티를 식별할 수 있는 속성 ex) 주민번호, 군번
- FK(Foreign Key) 속성 -> 다른 엔터티와의 관계에 포함된 속성
- 일반 속성 -> PK, FK에 포함되지 않은 다른 속성
3. 도메인 및 속성의 명명
-> 도메인: 각 속성이 가질 수 있는 값의 범위. 엔터니 내에서 속성에 대한 데이터 타입과 크기, 제약 사항 등을 지정
-> 속성의 명명
- 가능하면 업무에서 사용하는 용어를 사용
- 가능하면 축약어(shortcut)를 사용하지 않고 의미가 온전하게 드러날 수 있도록 작성
- 서술형보다는 명사형을 사용
- 수식어가 많이 붙지 않고 명확하게 의미를 파악
- 전체 데이터 모델에서 유일하게 작성
III) 관계(Relationship)
1. 관계의 개념
-> 관계의 정의: 엔터티와 인스턴스 사이의 논리적인 연관성
-> 관계의 페어링
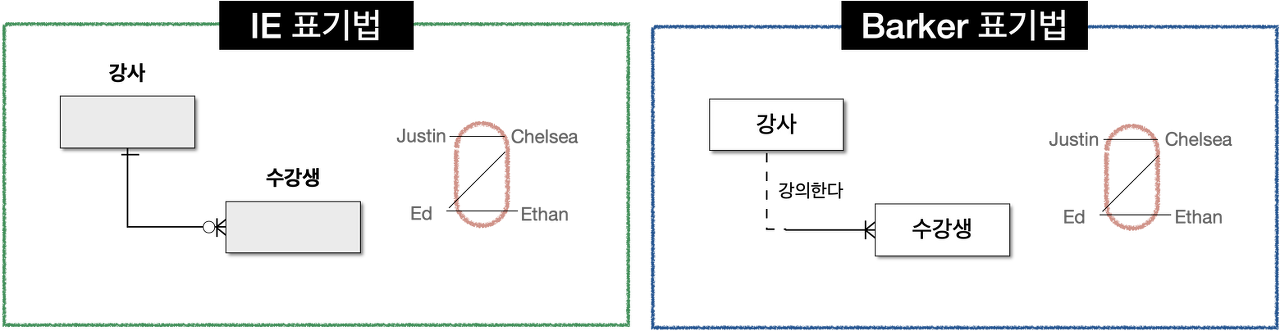
2. 관계의 분류
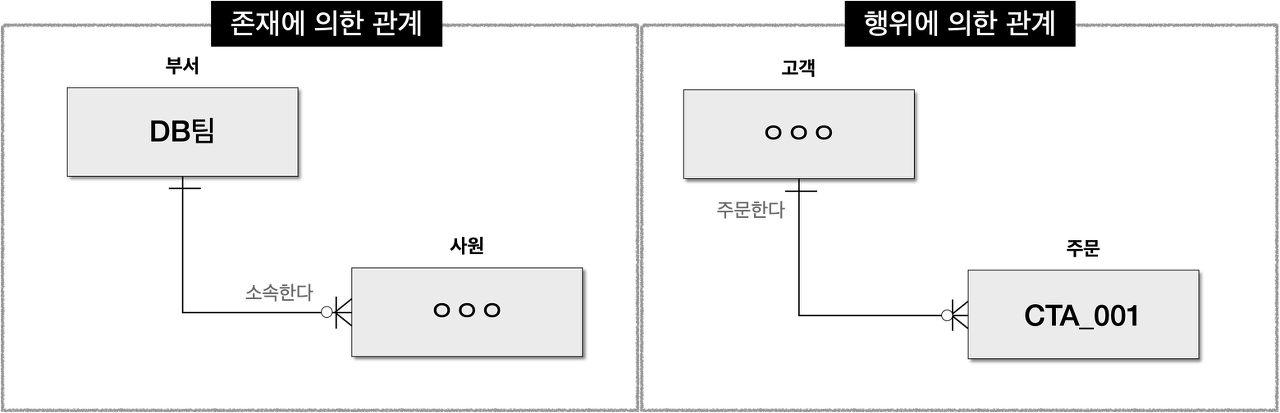
-> 존재에 의한 관계
- 인스턴스 간의 관계 -> 소속/포함의 형태
- ex) 회사에서 사원이 언제나 특정한 부서에 속해있는 것
-> 행위에 의한 관계
- 인스턴스 간의 관계 -> 행동/행위
- ex) 고객이 주문이라는 행동을 고객이 직접 행해야 발생
-> UML(Unified Modeling Language) - 통합 모델링 언어
- 표준화된 범용 모델링 언어
- 추상화된 시스템을 특정한 모델로 표현
- ERD와 달리 존재적 관계와 행위에 의한 관계를 구분하여, 연관 및 의존 관계로 표현
3. 관계의 표기법
-> 관계명: 각 관계는 두 개의 관계명을 갖음
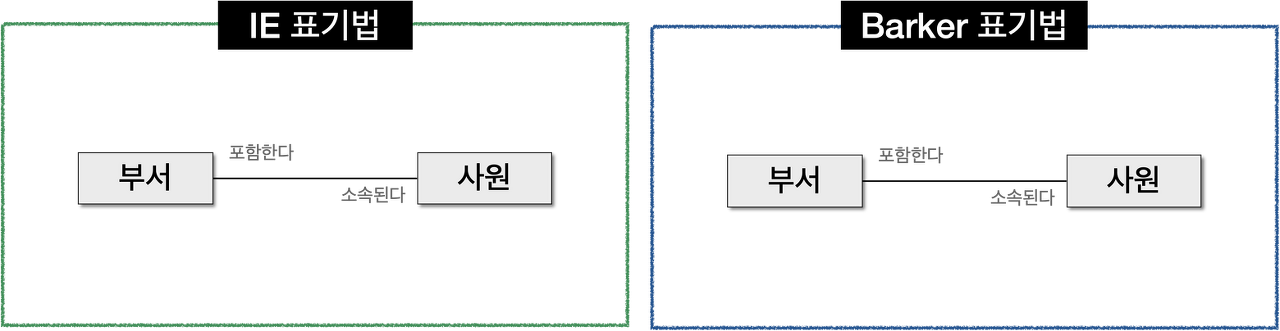
-> 관계 표기법

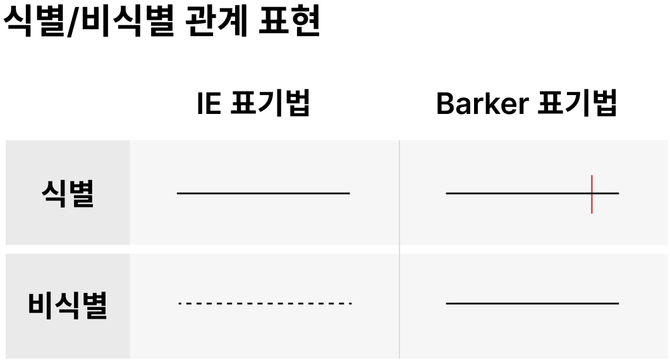
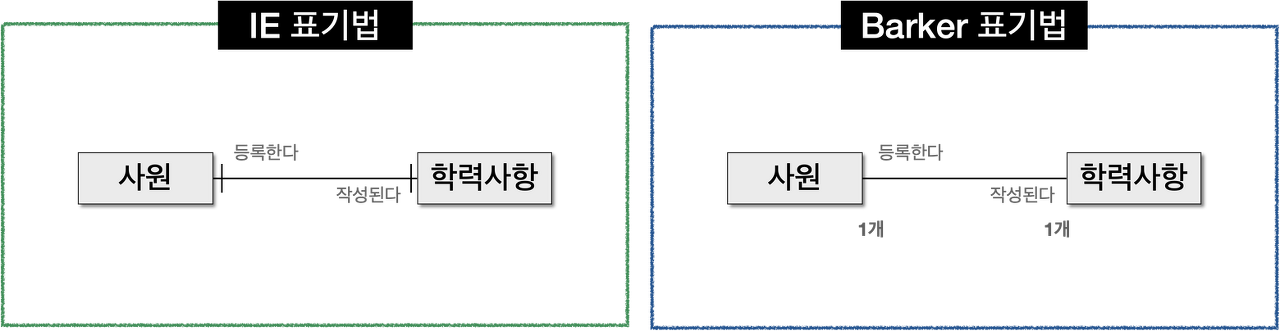
-> 관계차수(Degree / Cardinality)
- 1:1 (ONE TO ONE) 관계 표시 -> ex) 유저와 프로필 간의 관계
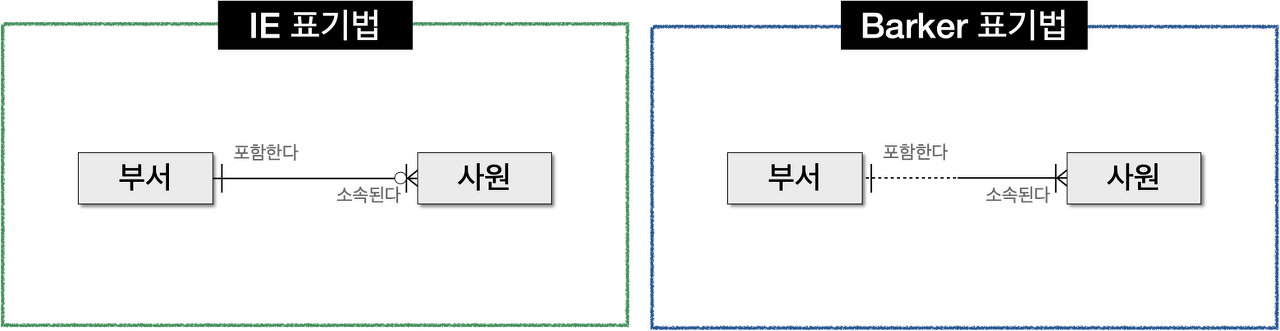
- 1:M (ONE TO MANY) 관계 표시 -> ex) 웹에서 댓글과 게시글의 관계
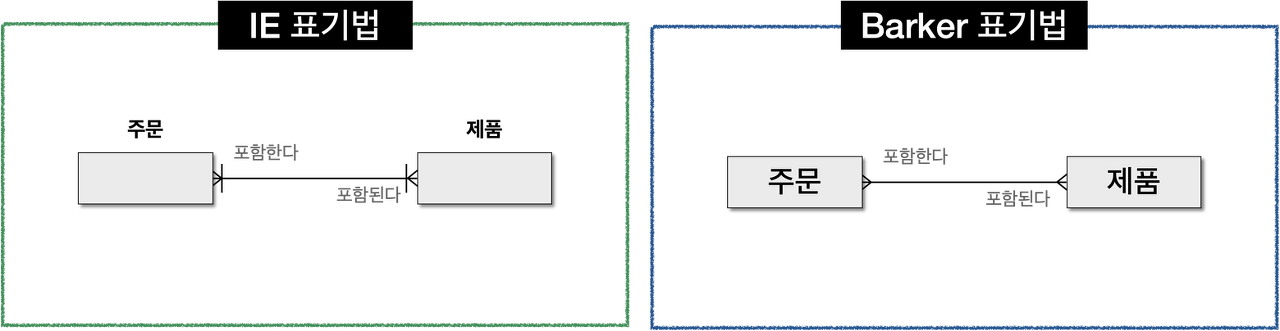
- M:N(MANY TO MANY) 관계 표시
-> 관계선택사양(Optionality)
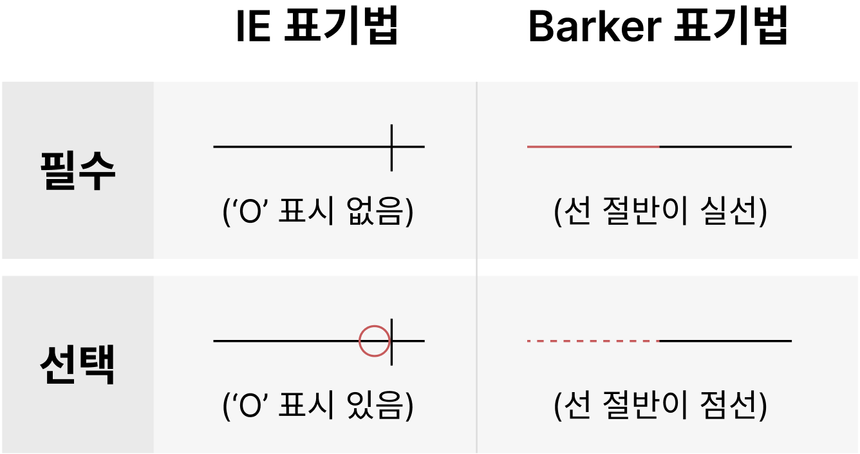
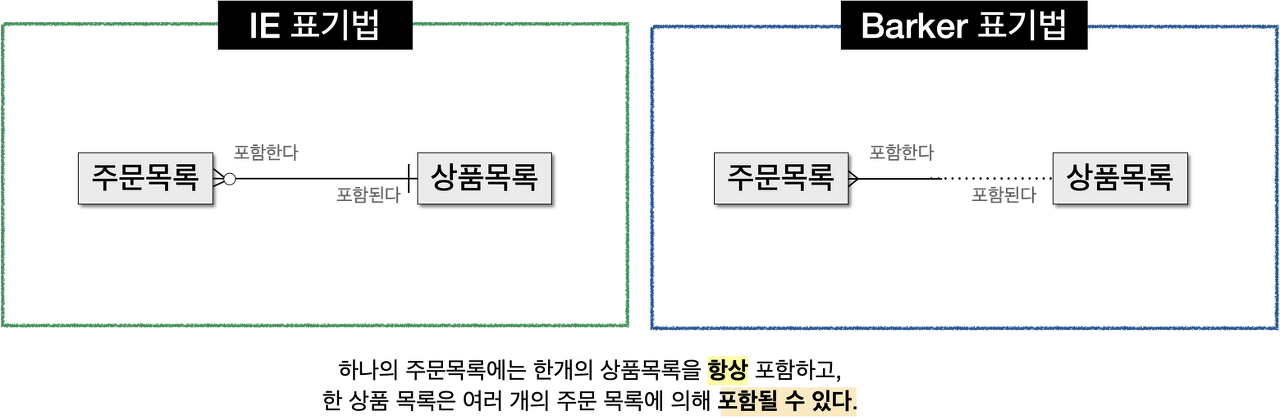
(1) 필수 조건
- 필수 사항은 실선으로 표시
- 상대 Entity에 대한 해당 조건을 만족하는 Entity가 반드시 존재할 경우에 표시
- ex) 게시글과 댓글의 관계에서 하나의 댓글은 게시글 없이는 존재할 수 없기 때문에 게시글은 반드시 존재 표현
- I로 표현(IE)
(2) 선택 조건
- 선택 사항은 점선으로 표시
- 상대 Entity에 대한 해당 조건을 만족하는 Entity가 존재할 수도 혹은 하지 않을 수도 있는 경우 표시
- ex) 게시글과 댓글의 관계에서 하나의 게시글에는 댓글이 달릴 수도 있고 달리지 않을 수도 있다
- O로 표현(IE)
4. 관계의 정의 및 읽는 방법
-> 관계 정의 시 체크 사항
- 두 엔터티 사이에는 관심 있는 연관 규칙이 존재하는지 여부
- 두 개의 엔터티 사이에 정보의 조합이 발생하는지 여부
- 업무 기술서, 장표에 관계 연결에 대한 규칙이 있는지 여부
- 업무 기술서, 장표에 관계 연결을 가능하게 하는 동사(Verb)가 있는지 여부
Ⅳ) 식별자(Identifier)
1. 식별자의 개념 및 특징
-> 식별자의 개념
- 집합체를 구분할 수 있는 구분자
- 하나의 엔터티에 구성되어 있는 여러 개의 속성 중에서 엔터티를 대표할 수 있는 속성
- 하나의 엔터니는 반드시 하나의 유일한 식별자 존재
-> 주식별자의 특징
- 유일성 -> 주식별자에 의해 엔터티 내에서 모든 인스턴스들을 유일하게 구분
- 최소성 -> 주식별자를 구성하는 속성의 수는 유일성을 만족하는 최소의 수
- 불변성 -> 한 번 특정 엔터티에 지정되면 그 식별자의 값은 변하지 않아야 함
- 존재성 -> 주식별자가 지정되면 반드시 데이터 값이 존재. NULL 값 허용X
2. 식별자 분류 및 표기법
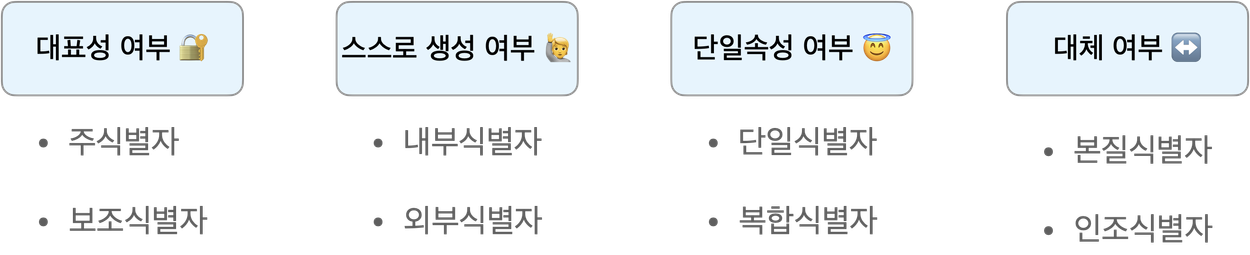
(1) 대표성 여부
- 주식별자 -> 엔터티 내에서 각 인스턴스를 구분할 수 있는 구분자. 다른 엔터티와 참조 관계를 연결할 수 있는 식별자
- 보조 식별자 -> 엔터티 내에서 각 인스턴스를 구분할 수 있는 구분자이나 대표성을 갖지 못해 참조 관계 연결 불가능
(2) 스스로 생성 여부
- 내부 식별자 -> 엔터티 내부에서 정의되는 식별자
- 외부 식별자 -> 다른 엔터티와의 관계를 통해 다른 엔터티로부터 받아오는 식별자
(3) 속성의 수
- 단일 식별자 -> 하나의 속성으로 구성된 식별자
- 복합 식별자 -> 둘 이상의 속성으로 구성된 식별자
(4) 대체 여부
- 본질 식별자 -> 업무에 의해 만들어지는 식별자
- 인조 식별자 -> 업무적으로 만들어지지는 않지만 원조 식별자가 복잡한 구성을 갖고 있기 때문에 인위적으로 만든 식별자
3. 주식별자 도출 기준
- 해당 업무에서 자주 이용되는 속성으로 설정
- 명칭, 내역 등과 같이 특정한 이름으로 기술되는 것은, 가능하면 주식별자로 사용X
- 복합으로 주식별자를 구성하는 경우 너무 많은 속성이 포함되지 않아야
'TIL > SQLD' 카테고리의 다른 글
| SQLD 1주차 + 2주차 (1) | 2023.12.26 |
|---|
