1. 선형 회귀 이론
- X: 독립변수, 원인변수, 설명변수
- Y: 종속변수, 결과변수
Y = wX + b
# w: 가중치
# b: 편향(Bias)
# w,X가 주어지면 Y값도 도출 가능
2. 회귀 분석 평가 지표
MSE
1. 에러 정의 방법
방법1) 에러 = 실제 데이터 - 예측 데이터
방법2) 에러를 제곱하여 모두 양수로 만들고 다 합치기
방법3) 그 값에다가 데이터 수만큼 나누기
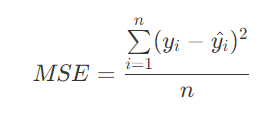
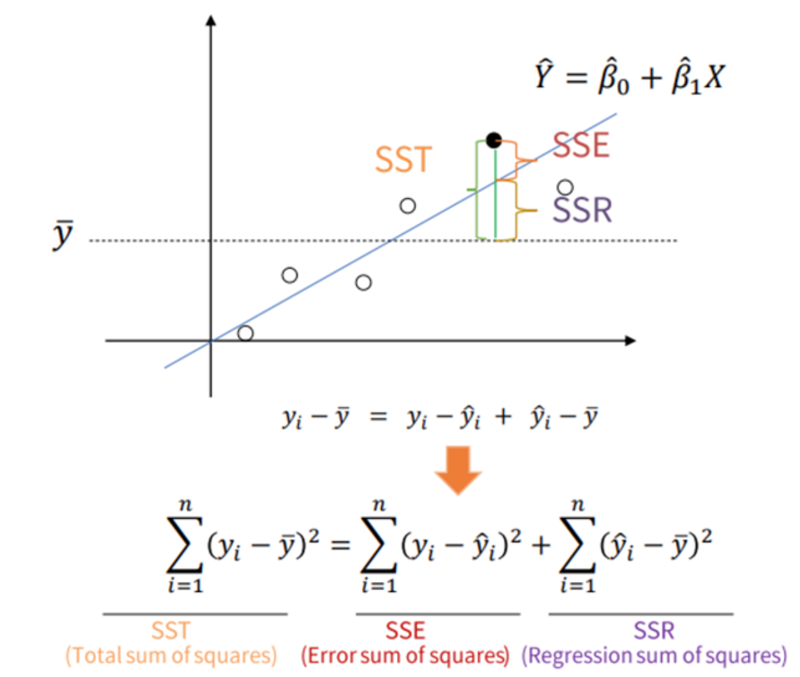
R Square
1. 선형 회귀만의 평가 지표
2. 전체 모형에서 회귀선으로 설명할 수 있는 정도
3. 선형 회귀 적용
- coef_: 회귀 계수(가중치, w)
- intercept_: 편향(bias, b)
- fit: 데이터 학습
- predict: 데이터 예측
4. 선형 회귀 심화
(1) 다중 선형 회귀
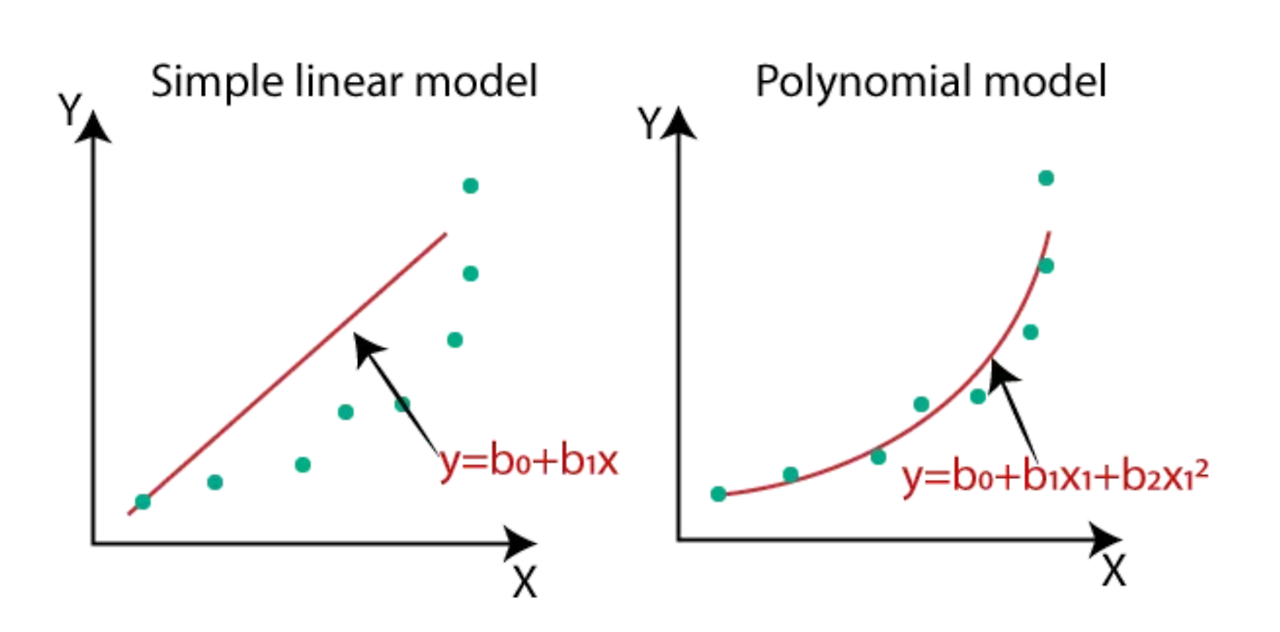
- 단순 선형 회귀: X변수가 1개
- 다중 선형 회귀: X변수가 2개 이상
(2) 범주형 데이터 사용하기
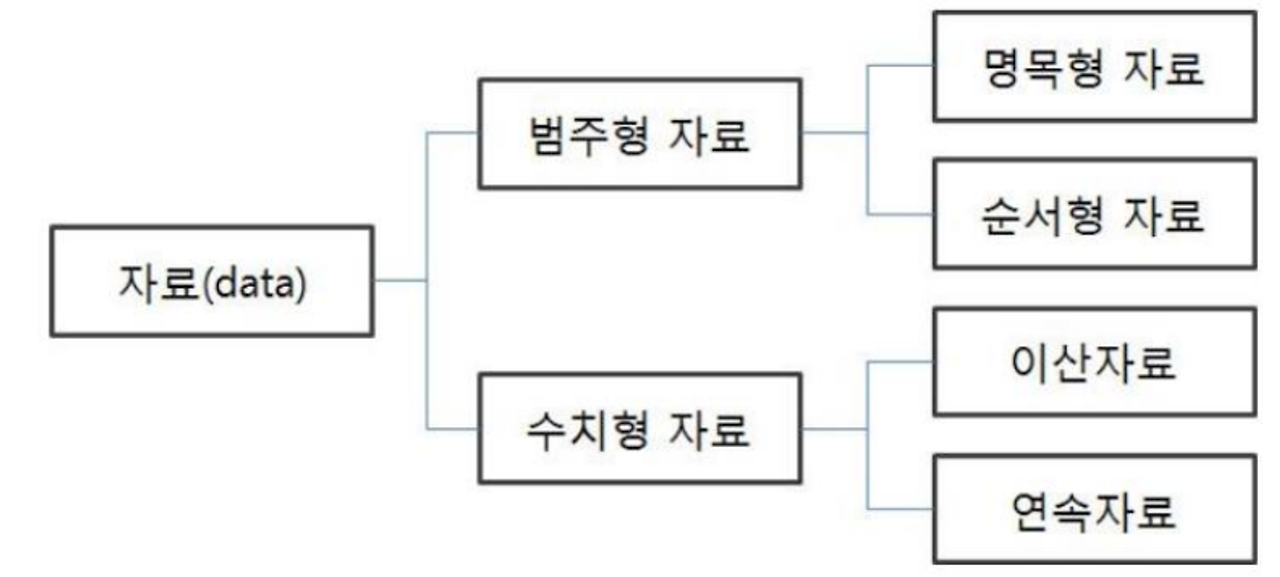
- 명목형 자료: 자료의 순서가 의미X (혈액형, 성별)
- 순서형 자료: 자료의 순서가 의미O (학점, 등급)
- 이산자료: 두 개의 값이 유한한 개수로 나누어진 데이터(주사위 눈, 나이)
- 연속자료: 두 개의 값이 무한한 개수로 나누어진 데이터(키, 몸무게)
Encodiing: 숫자가 아닌 범주형 데이터를 숫자로 바꾸는 것
# 범주형 데이터를 숫자로 바꾸는 함수
def get_sex(x):
    if x == 'Female':
        return 0
    else:
        return 1

# apply(함수): 함수를 돌면서 조건을 적용
# 'sex_en' 컬럼에 여자는 0, 남자는 1인 데이터가 투입
tips_df['sex_en'] = tips_df['sex'].apply(get_sex)
(3) 선형 회귀의 가정
- 선형성(Linearrity): 종속변수(Y)와 독립변수(X) 간에 선형 관계가 존재해야 함
- 등분산성(Homoscedasticity): 오차가 특정 패턴을 보여서는 안 되며, 독립 변수의 값에 상관없이 일정해야 함
- 정규성(Normality): 오차항은 정규 분포를 따라야 함
- 독립성(Independence): X변수는 서로 독립적이어야 함
다중공선성(Multicolinearity): 회귀분석에서 독립변수(X)간의 강한 상관관계가 나타나는 것
해결방법? 서로 상관관계가 높은 변수 중 하나만 선택
(4) 선형 회귀 정리
- 장점: 직관적, X-Y 관계를 정량화 가능, 모델이 빠르게 학습
- 단점: X-Y간의 선형성 가정이 필요, 평가지표가 평균을 포함하기 때문에 이상치에 민감, 인코딩 시 정보 손실 발생
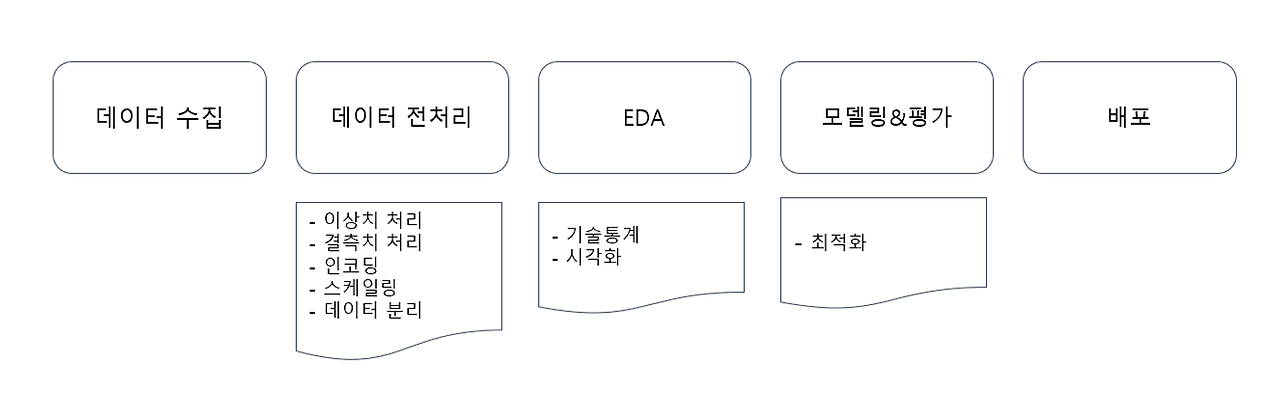
5. 데이터 프로세스 개요
### 선형 회귀 순서 ###
### 가정) tips 데이터에서 x를 total_bill, y를 tip으로 하자
# 1. 데이터 가져오기
tips_df = sns.load_dataset('tips')

# 2. 선형 회귀 모델 생성
model_lr = LinearRegression()

# 3. 데이터 프레임을 이용하여 x,y 변수 생성
x = tips_df[['total_bill']]
y = tips_df[['tip']]

# 4. 데이터 훈련
model_lr.fit(X=x, y=y)

# 5. 가중치, 편향 구하기
print(model_lr.coef_)
print(model_lr.intercept_)

# 6. 5에서 나온 값을 가지고, 리스트를 이용해 변수에 할당
w = model_lr.coef_[0][0]
bias = model_lr.intercept_[0]

# 7. 1차 방정식 구하기
print('y = {}x + {}'.format(w.round(2), bias.round(2))) # y = 0.11X + 0.92

# 8. 에러를 구하기 위해 실제값과 예측값 구하기
y_true = tips_df['tip'] # 변수 Y 실제값
y_pred = model_lr.predict(tips_df[['total_bill']]) # 변수 Y 예측값, X변수를 넣어서 구한다

# 9. 회귀 분석 평가
mean_squared_error(y_true, y_pred)
r2_score(y_true, y_pred)

# 10. 예측값 데이터 프레임에 추가
tips_df['pred'] = y_pred

# 11. 산점도 그래프 그리기(라인은 예측한 것)
sns.scatterplot(data=tips_df, x='total_bill', y='tip')
sns.lineplot(data=tips_df, x='total_bill', y='pred', color = 'red')'TIL > 머신러닝' 카테고리의 다른 글
| 분류 분석 - 로지스틱 회귀 (1) | 2024.01.31 |
|---|---|
| 머신러닝 기초 (0) | 2024.01.29 |

